Skip to content

Conçu pour : Équipes MLOps francophones sur OVHcloud, Scaleway et clusters Slurm ou Kubernetes européens

Séparer les pannes réseau RDMA/RoCE des erreurs Xid 79 et OOM hôte

Recoupez automatiquement les timeouts collectifs WorkNCCL, les erreurs de complétion ibv_poll_cq 12 et les événements noyau NVRM Xid afin d'escalader le bon noeud.

Évaluation Team 30 jours. Sans carte bancaire ni renouvellement automatique.

Diagnostic en direct sans inscription

Analyser un journal multi-noeuds France / UE

Collez un journal masqué d'entraînement, dmesg ou NCCL_DEBUG=INFO pour obtenir la cause première citée et la prochaine vérification.

Consultez avant envoi : traitement cloud et exécution 100 % locale hors ligne.

training_logs.txt
Pas de log sous la main ? Choisissez un exemple :

Les fichiers volumineux sont condensés dans votre navigateur. Seules les preuves sélectionnées sont transmises au diagnostic.

3 diagnostics cloud gratuits par jour

Essayez Denpex pendant 30 jours. GRATUIT.

Sans carte bancaire. Sans abonnement automatique. Vérifiez l'utilité de Denpex sur un incident que vous connaissez déjà.

Démarrer votre évaluation Team gratuite de 30 jours

Jusqu'à 50 diagnostics par jour pendant 30 jours. Vérifiez votre e-mail professionnel pour activer votre essai d'entreprise, rejouez un incident déjà résolu et comparez les preuves avec la cause confirmée par votre équipe.

Utilisez votre adresse d'entreprise, par exemple alex@votreentreprise.fr.

Qui est éligible ?

Tout domaine d'entreprise vérifié active l'évaluation Team gratuite de 30 jours (jusqu'à 50 diagnostics/jour), quel que soit votre hébergeur mail. En cas d'échec de vérification automatique, contactez support@denpex.com. Le diagnostic local dans l'extension éditeur ne nécessite aucun compte.

Vous utilisez une adresse personnelle (Gmail, Outlook, Orange) ou un cluster solo ? Créer un compte gratuit à 0 $ (sans e-mail pro) pour conserver 7 jours d'historique, ou envoyez un journal d'erreur pour une démonstration.

Ce qu'une évaluation de 30 jours valide

Synthèse factuelle prête pour vos équipes SRE ou le support fournisseur.

Denpex remonte uniquement les faits citables du log fourni et signale explicitement toute preuve encore absente.

Aperçu de Denpex

Inspectez les preuves exactes du journal plutôt que des hypothèses

Remontez la chaîne causale, examinez les lignes citées et préparez le transfert vers l'équipe infrastructure. Cliquez sur une capture pour l'ouvrir en pleine résolution.

Suivre une cascade jusqu'à la faute initiale
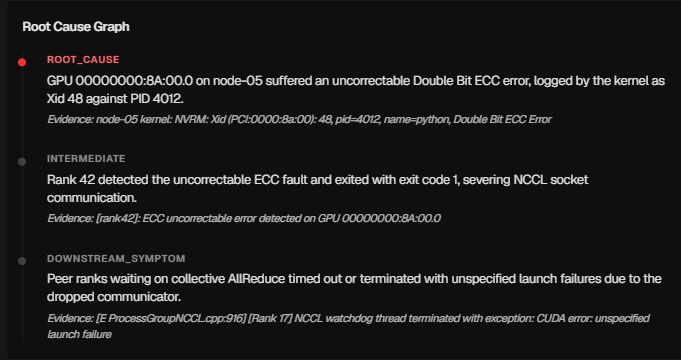
Graphe causal Denpex reliant un événement ECC Xid 48 à la perte d'un rank et aux timeouts NCCL suivants avec lignes citées.
Capture issue d'un exemple NCCL/ECC : relie événement matériel, arrêt de rank et symptômes aval avec citations.Voir l'image d'origine

Préparer les preuves pour le dossier matériel RMA
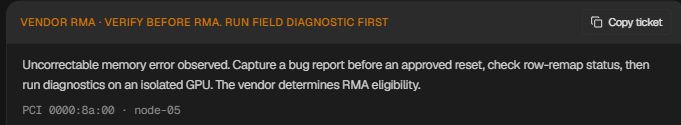
Synthèse matérielle Denpex demandant de conserver UUID et dmesg avant tout redémarrage.
Synthèse matérielle du même cas : capture des preuves de diagnostic avant approbation d'un reset.Voir l'image d'origine

Afficher clairement ce qu'il manque à prouver
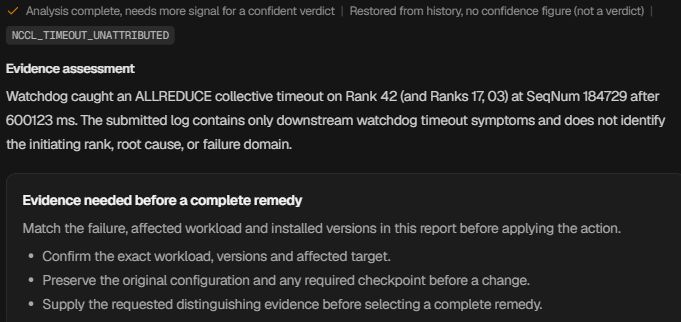
Évaluation Denpex expliquant qu'un simple timeout AllReduce seul ne désigne pas le rank initial.
Évaluation des preuves manquantes : précise quels journaux recueillir avant d'agir.Voir l'image d'origine

Conclure l'investigation dans l'éditeur
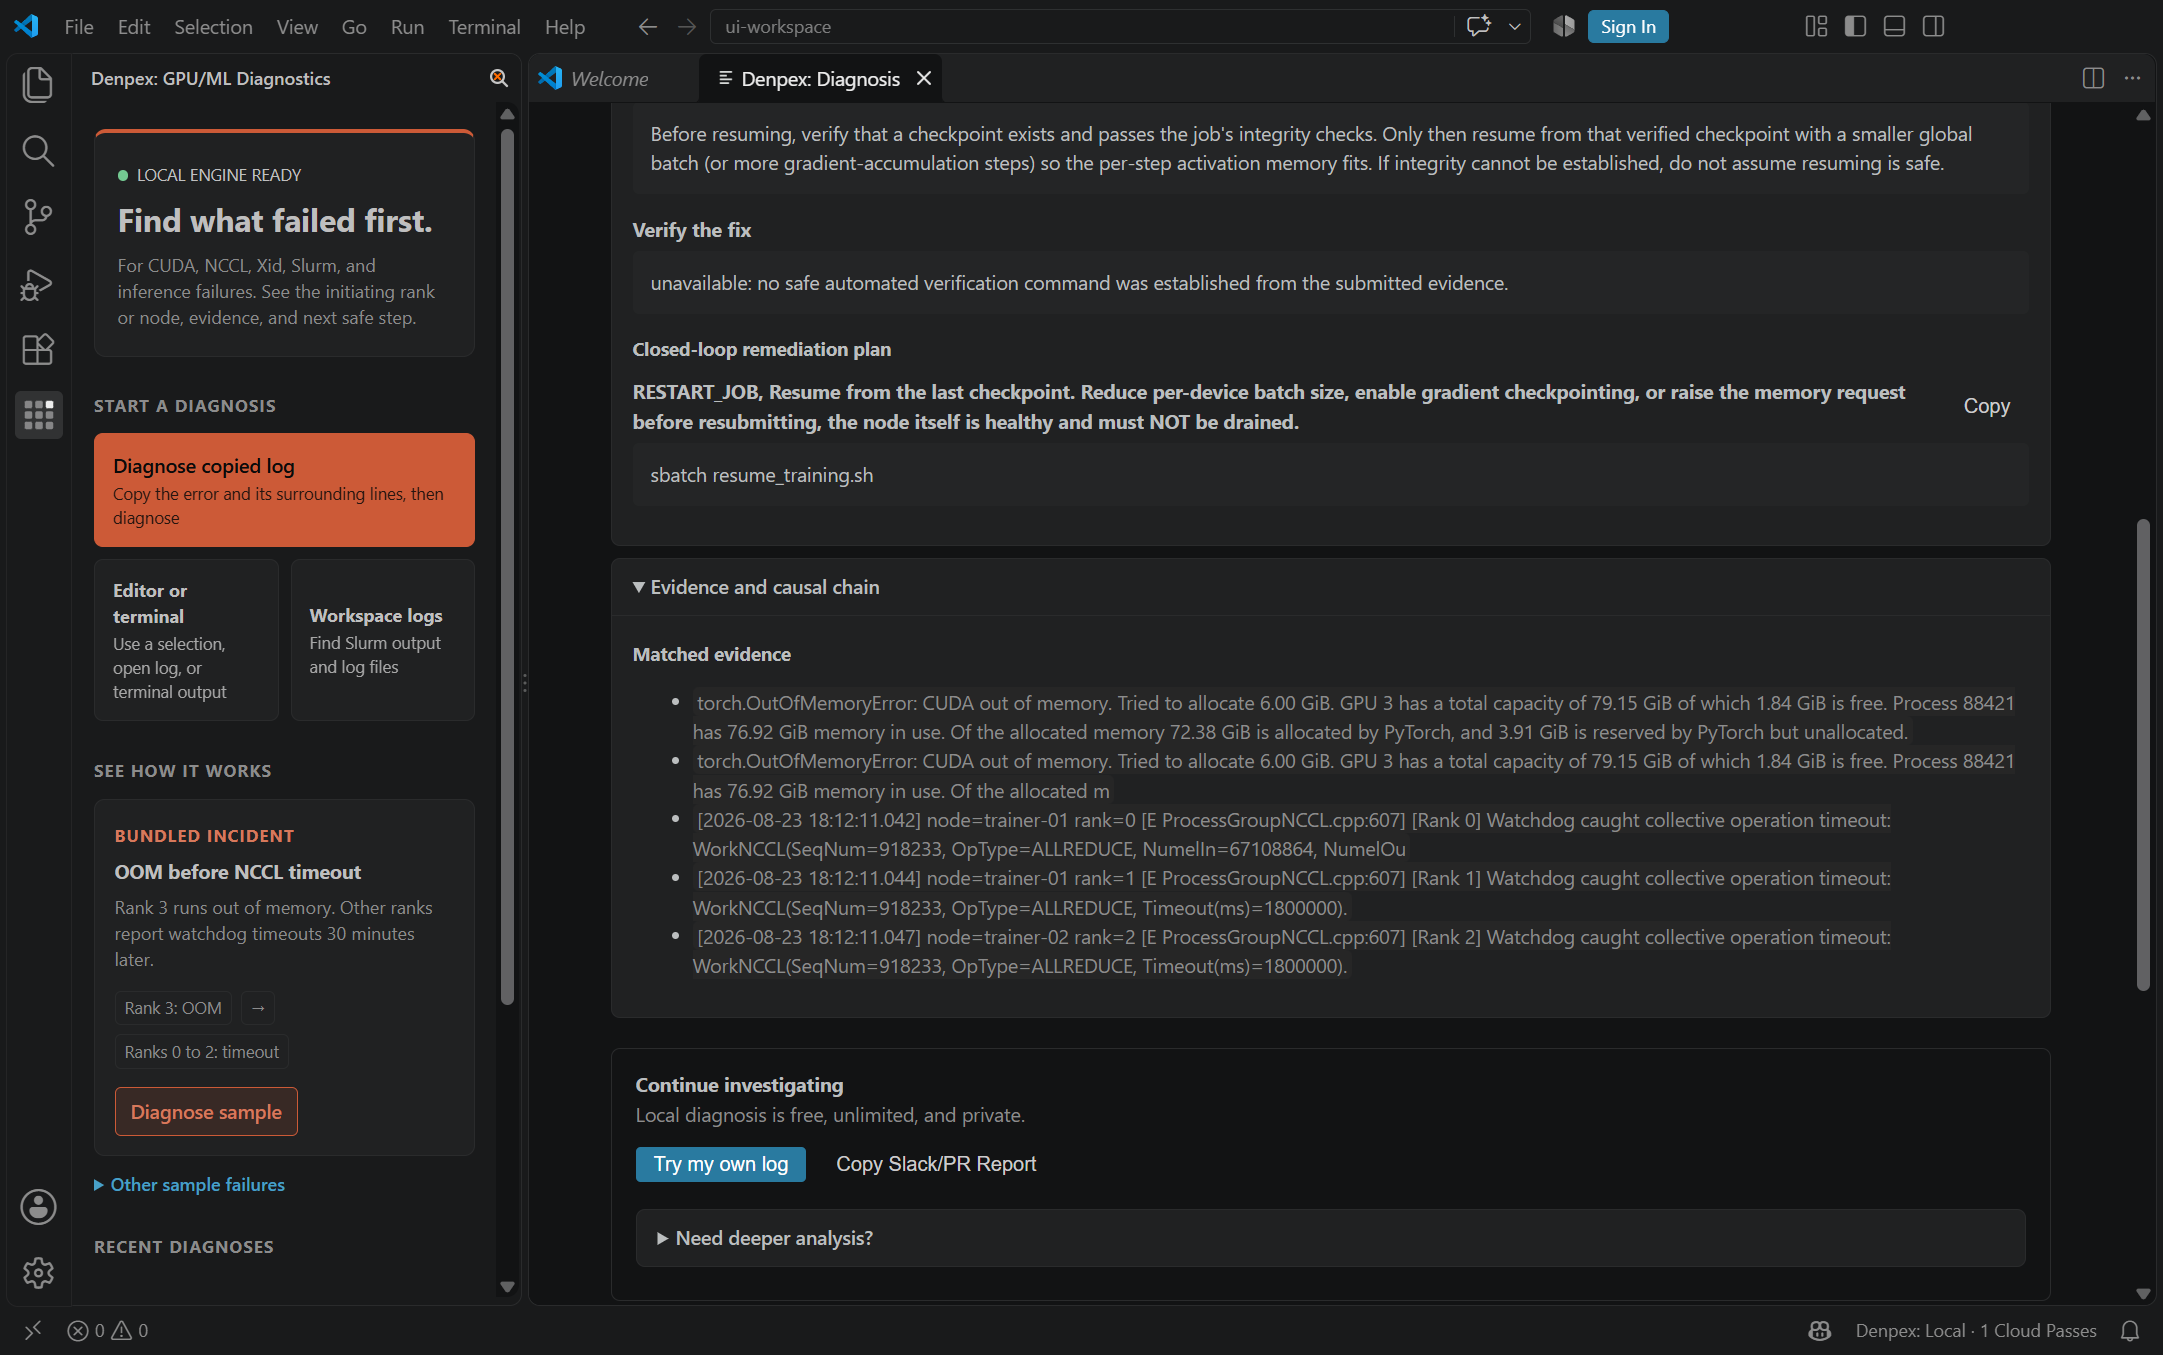
Extension VS Code Denpex affichant l'exemple OOM-before-NCCL, les lignes concordantes et les étapes suivantes.
Capture de l'extension VS Code : preuves citées et vérifications sans quitter l'éditeur.Voir l'image d'origine
Signature fréquemment rencontrée

OVHcloud & Scaleway France H100 - (vérification sur vos logs)

Voir la documentation OVHcloud GPU

Schéma d'incident courant

Lorsqu'un entraînement FSDP ou DeepSpeed se fige sur 4 à 16 noeuds H100 après une perte de lien mlx5 ou un OOM DataLoader, identifiez le premier rank touché.

Extrait typique de trace (OVHcloud & Scaleway France H100)
par-h100-node-04:5120:5184 [2] misc/ibvwrap.cc:284 NCCL WARN Call to ibv_poll_cq returned error 12 (Transport retry counter exceeded)
NVRM: Xid (PCI:0000:4b:00): 79, pid=14021, name=vllm, GPU has fallen off the bus.

Variables de diagnostic à activer avant le prochain run

Configurez ces variables dans votre conteneur ou script de lancement pour capturer l'origine exacte du blocage :

NCCL_DEBUG=INFONCCL_IB_HCA=mlx5TORCH_NCCL_ASYNC_ERROR_HANDLING=1CUDA_DEVICE_ORDER=PCI_BUS_ID

Limites du diagnostic et confidentialité

Denpex analyse uniquement les journaux fournis par l'utilisateur sans accès aux identifiants cloud ou aux clusters privés.

Autres workflows par fournisseur cloud GPU

Comparez les diagnostics multi-noeuds sur InfiniBand, RoCEv2, Kubernetes et Slurm.

RunPoden
Separate container socket misrouting from a true worker stall on RunPod.
Lambdaen
Distinguish an InfiniBand mlx5 fabric flap from an application rank stall on Lambda.
Vast.aien
Isolate motherboard PCIe P2P restrictions and /dev/shm limits on Vast.ai hosts.
Scalewayen
Separate RoCE v2 GID routing mismatches from DeepSpeed ZeRO-3 stage stalls on Scaleway.
CoreWeaveen
Link Kubernetes pod restarts directly to underlying Xid 79 or NVLink hardware faults.
Crusoe Clouden
Pinpoint which straggler rank or RoCE link slowed down your Crusoe Cloud cluster.
Hetzneren
Fix vSwitch MTU fragmentation and NCCL socket discovery on Hetzner bare metal.
TensorDocken
Untangle NAT port forwarding and c10d rendezvous timeouts on TensorDock VMs.
さくらインターネット 高火力ja
さくら高火力サービスにおけるH100 NDR/RoCE NCCLタイムアウトの自動診断
GPUSOROBAN (Highreso)ja
GPUSOROBANにおける多重GPU P2P通信ストールとPCIeトポロジ競合の解決
네이버 클라우드 플랫폼ko
네이버 클라우드 GPU 인스턴스 DDP 랑데부 멈춤 및 VPC MTU 병목 진단
TWCC (台灣智慧雲 / Taiwania)zh-TW
TWCC 台灣智慧雲 GPU 叢集 Xid 79 PCIe 掉卡與 Slurm 任務卡死自動診斷
Nebiusen
Isolate InfiniBand fabric drops and Soperator node faults on Nebius.
KakaoCloudko
KakaoCloud GPU 클러스터의 NCCL 타임아웃과 네트워크 병목 분리 진단
SMC (Sustainable Metal Cloud Singapore)en
Isolate InfiniBand NDR rail faults and multi-node NCCL stalls in Singapore.
Hyperstack (UK & Europe)en-GB
Separate UK VM network bottlenecks from H100 hardware drops on Hyperstack.
CUDO Compute (UK & Europe)en-GB
Untangle virtualized PCIe topology and /dev/shm traps on CUDO Compute.
OVHcloud (France & Europe)en
Isolate OVHcloud vRack VLAN fragmentation from GPU silicon faults.
Verne & Nordic H100 Clustersen
Separate Slurm cgroup evictions from InfiniBand stalls on Nordic clusters.
Core42 (UAE Sovereign AI Cloud)en
Pinpoint initiating silicon and InfiniBand faults in thousand-GPU runs.
Firmus & ResetData (Australia)en
Separate network topology timeouts from hardware Xids on Australian GPUs.
KT Cloud · NHN Cloud (한국 GPU 클러스터)ko
KT Cloud · NHN Cloud 멀티노드 H100 환경의 NCCL 타임아웃 원인 분리
GMO GPUクラウド · ABCI 3.0 (H200)ja
H200 InfiniBand NDR 通信障害と Slurm 強制終了を瞬時に切り分け
Ubilink 友崴超算 (台灣與港澳 H100 叢集)zh-TW
精準隔離 Ubilink H100 多節點訓練中的鏈路異常與硬體掉卡
Hetzner Deutschland & DACH GPU Clusterde
PCIe-P2P-Hänger, NCCL-Timeouts und Xid 79 auf DACH-GPU-Servern sauber isolieren
España y LATAM GPU H100 / vLLMes
Separa errores de red NCCL, caídas PCIe Xid 79 y límites de memoria vLLM
Brasil e LATAM GPU H100 (NCCL / OOM)pt
Separe CUDA OOM, falhas de link NCCL e quedas Xid 79 antes de reiniciar nós