Skip to content

Para Engenheiros de ML, MLOps e infraestrutura em São Paulo, Brasil, Lisboa e América Latina

Separe CUDA OOM, falhas de link NCCL e quedas Xid 79 antes de reiniciar nós

Isole o primeiro rank que falhou em treinos DDP/FSDP e inferência vLLM usando apenas evidências citadas dos seus logs, sem misturar OOM de CPU com VRAM.

Avaliação Team de 30 dias. Sem cartão de crédito e sem cobrança automática.

Diagnóstico ao vivo sem cadastro

Analisar log de cluster GPU em português

Cole um log mascarado de treino, dmesg ou NCCL_DEBUG=INFO para receber a causa raiz citada e a próxima verificação segura.

Antes de enviar, confira tratamento de dados em nuvem e opções locais offline.

training_logs.txt
Não tem um log à mão? Escolha um exemplo:

Arquivos grandes são compactados no navegador. Apenas as evidências selecionadas são enviadas ao diagnóstico.

3 diagnósticos em nuvem grátis por dia

Experimente o Denpex por 30 dias. GRÁTIS.

Sem cartão de crédito. Sem assinatura automática. Veja se o Denpex ajuda em um incidente que você já conhece.

Inicie sua avaliação Team gratuita de 30 dias

Até 50 diagnósticos por dia durante 30 dias. Verifique seu e-mail corporativo para ativar uma avaliação elegível, reproduza um incidente já resolvido e compare as evidências com a causa confirmada pela sua equipe.

Use seu e-mail da empresa, por exemplo alex@suaempresa.com.

Quem é elegível?

Domínios corporativos ativam a avaliação gratuita de 30 dias após a verificação do e-mail e domínio. Se a validação automática falhar, fale com support@denpex.com. O diagnóstico local na extensão do editor dispensa conta.

Usando e-mail pessoal (Gmail, Outlook) ou cluster solo? Criar conta gratuita de $0 (não exige e-mail corporativo) para salvar histórico de 7 dias, ou envie um log de falha para demonstração ao vivo.

O que uma avaliação de 30 dias comprova

Laudo técnico objetivo para acionamento de suporte cloud ou ajuste de batch.

Denpex reporta apenas o que é diretamente citado no log enviado e destaca o que ainda exige confirmação extra.

Por dentro do Denpex

Veja a evidência citada no log, não apenas uma suposição

Acompanhe a cadeia causal, verifique as linhas originais citadas e prepare o repasse para o time de infraestrutura. Clique em qualquer captura para abrir em tamanho real.

Rastreie falhas em cascata até a origem
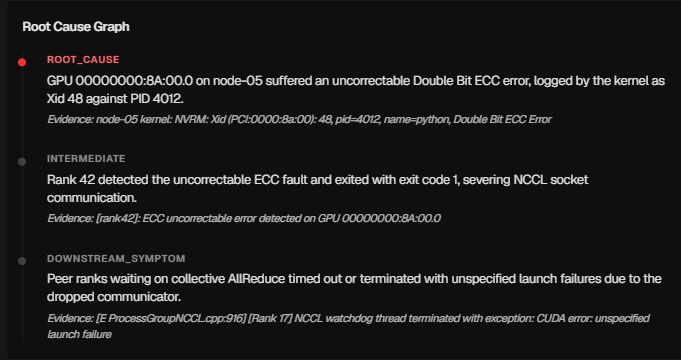
Grafo causal do Denpex ligando erro ECC Xid 48 ao encerramento do rank e aos timeouts NCCL subsequentes.
Captura de um incidente NCCL/ECC conectando evento físico, saída de rank e sintomas em cascata com citações.Ver imagem original

Prepare evidências para abertura de RMA
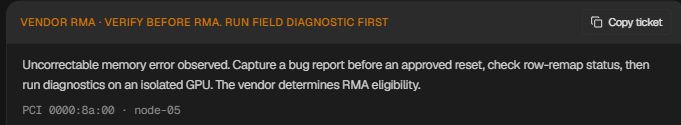
Resumo físico do Denpex orientando preservar UUID e dmesg antes de aprovar reset do nó.
Visão de repasse de hardware do mesmo caso: guarda evidências antes do reinício.Ver imagem original

Indique claramente quais provas ainda faltam
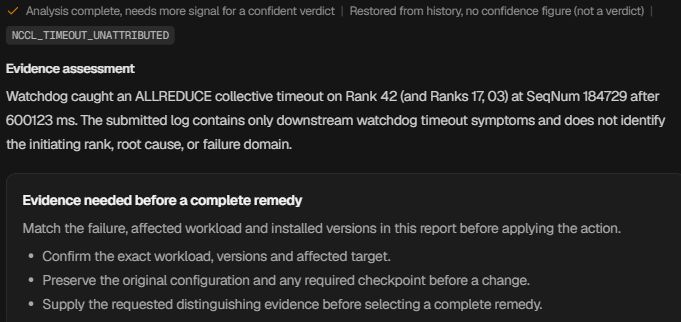
Avaliação do Denpex explicando que apenas timeouts AllReduce não provam qual rank iniciou a parada.
Avaliação transparente de lacunas antes de reiniciar nós saudáveis.Ver imagem original

Conclua a análise dentro do editor

Extensão VS Code Denpex mostrando o exemplo OOM-before-NCCL, linhas correspondentes e próximos passos.
Captura real da extensão VS Code: consulte evidências e validação sem sair do editor.Ver imagem original
Assinatura comum de falha

Brasil e LATAM GPU H100 (NCCL / OOM) - (validação no log fornecido)

Abrir calculadora VRAM em português

Padrão típico de incidente

Se um trabalho distribuído em várias GPUs para por timeout coletivo NCCL depois de um worker sofrer Xid 79 ou falta de RAM no DataLoader, identifique imediatamente o nó causador.

Trecho ilustrativo de falha (Brasil e LATAM GPU H100 (NCCL / OOM))
sp-h100-02:6420:6488 [3] misc/ibvwrap.cc:284 NCCL WARN Call to ibv_poll_cq returned error 12 (Transport retry counter exceeded)
torch.OutOfMemoryError: CUDA out of memory. Tried to allocate 1.50 GiB.

Flags recomendadas para capturar evidência completa

Configure estas variáveis de ambiente no container ou script de execução para isolar o rank inicial:

NCCL_DEBUG=INFOTORCH_NCCL_ASYNC_ERROR_HANDLING=1TORCH_NCCL_DUMP_ON_TIMEOUT=1CUDA_DEVICE_ORDER=PCI_BUS_ID

Limites de escopo e privacidade

Denpex analisa apenas o texto de log fornecido pelo usuário, com mascaramento prévio no navegador e sem acesso a credenciais privadas.

Outros fluxos por provedor GPU

Compare padrões de falha em redes InfiniBand, RoCEv2, Kubernetes e bare-metal.

RunPoden
Separate container socket misrouting from a true worker stall on RunPod.
Lambdaen
Distinguish an InfiniBand mlx5 fabric flap from an application rank stall on Lambda.
Vast.aien
Isolate motherboard PCIe P2P restrictions and /dev/shm limits on Vast.ai hosts.
Scalewayen
Separate RoCE v2 GID routing mismatches from DeepSpeed ZeRO-3 stage stalls on Scaleway.
CoreWeaveen
Link Kubernetes pod restarts directly to underlying Xid 79 or NVLink hardware faults.
Crusoe Clouden
Pinpoint which straggler rank or RoCE link slowed down your Crusoe Cloud cluster.
Hetzneren
Fix vSwitch MTU fragmentation and NCCL socket discovery on Hetzner bare metal.
TensorDocken
Untangle NAT port forwarding and c10d rendezvous timeouts on TensorDock VMs.
さくらインターネット 高火力ja
さくら高火力サービスにおけるH100 NDR/RoCE NCCLタイムアウトの自動診断
GPUSOROBAN (Highreso)ja
GPUSOROBANにおける多重GPU P2P通信ストールとPCIeトポロジ競合の解決
네이버 클라우드 플랫폼ko
네이버 클라우드 GPU 인스턴스 DDP 랑데부 멈춤 및 VPC MTU 병목 진단
TWCC (台灣智慧雲 / Taiwania)zh-TW
TWCC 台灣智慧雲 GPU 叢集 Xid 79 PCIe 掉卡與 Slurm 任務卡死自動診斷
Nebiusen
Isolate InfiniBand fabric drops and Soperator node faults on Nebius.
KakaoCloudko
KakaoCloud GPU 클러스터의 NCCL 타임아웃과 네트워크 병목 분리 진단
SMC (Sustainable Metal Cloud Singapore)en
Isolate InfiniBand NDR rail faults and multi-node NCCL stalls in Singapore.
Hyperstack (UK & Europe)en-GB
Separate UK VM network bottlenecks from H100 hardware drops on Hyperstack.
CUDO Compute (UK & Europe)en-GB
Untangle virtualized PCIe topology and /dev/shm traps on CUDO Compute.
OVHcloud (France & Europe)en
Isolate OVHcloud vRack VLAN fragmentation from GPU silicon faults.
Verne & Nordic H100 Clustersen
Separate Slurm cgroup evictions from InfiniBand stalls on Nordic clusters.
Core42 (UAE Sovereign AI Cloud)en
Pinpoint initiating silicon and InfiniBand faults in thousand-GPU runs.
Firmus & ResetData (Australia)en
Separate network topology timeouts from hardware Xids on Australian GPUs.
KT Cloud · NHN Cloud (한국 GPU 클러스터)ko
KT Cloud · NHN Cloud 멀티노드 H100 환경의 NCCL 타임아웃 원인 분리
GMO GPUクラウド · ABCI 3.0 (H200)ja
H200 InfiniBand NDR 通信障害と Slurm 強制終了を瞬時に切り分け
Ubilink 友崴超算 (台灣與港澳 H100 叢集)zh-TW
精準隔離 Ubilink H100 多節點訓練中的鏈路異常與硬體掉卡
Hetzner Deutschland & DACH GPU Clusterde
PCIe-P2P-Hänger, NCCL-Timeouts und Xid 79 auf DACH-GPU-Servern sauber isolieren
OVHcloud & Scaleway France H100fr
Séparer les pannes réseau RDMA/RoCE des erreurs Xid 79 et OOM hôte
España y LATAM GPU H100 / vLLMes
Separa errores de red NCCL, caídas PCIe Xid 79 y límites de memoria vLLM