Skip to content

Para Equipos de IA, MLOps e infraestructura en España, México, Colombia, Chile y Argentina

Separa errores de red NCCL, caídas PCIe Xid 79 y límites de memoria vLLM

Convierte trazas mezcladas de PyTorch DDP/FSDP, vLLM y dmesg en una línea causal verificable indicando el primer nodo o rango que inició la cascada.

Evaluación Team de 30 días. Sin tarjeta ni cobros automáticos.

Diagnóstico en vivo sin registro

Probar diagnóstico con un log multi-nodo en español

Pega un registro anonimizado de entrenamiento, dmesg o NCCL_DEBUG=INFO para aislar la causa raíz y el siguiente paso seguro.

Revisa antes de subir: gestión de datos en la nube y opción 100 % local.

training_logs.txt
¿No tienes un log a mano? Carga un ejemplo:

Los archivos grandes se condensan en tu navegador. Solo la evidencia seleccionada se envía al diagnosticar.

3 diagnósticos cloud gratuitos al día

Prueba Denpex por 30 días. GRATIS.

Sin tarjeta de crédito. Sin suscripción automática. Comprueba si Denpex ayuda con un incidente que ya conoces.

Inicia tu evaluación Team gratuita de 30 días

Hasta 50 diagnósticos diarios durante 30 días. Verifica tu correo laboral para activar una evaluación empresarial elegible, reproduce un incidente resuelto y compara la evidencia con la causa confirmada por tu equipo.

Usa el correo de tu empresa, por ejemplo alex@tuempresa.com.

¿Quién califica?

Los dominios corporativos activan la evaluación gratuita de 30 días tras validar el correo y dominio. Si no podemos verificarlo automáticamente, escribe a support@denpex.com. El diagnóstico local en el editor no requiere cuenta.

¿Usas correo personal (Gmail, Outlook) o un clúster individual? Crea una cuenta gratuita de $0 (sin correo de trabajo) para guardar 7 días de historial, o envía un log de error para una revisión en vivo.

Qué demuestra una evaluación de 30 días

Informe con evidencia citada listo para soporte de hardware o equipo de plataforma.

Denpex solo afirma lo respaldado por citas exactas del log e indica cuando falta evidencia adicional.

Dentro de Denpex

Revisa la evidencia exacta del log, no solo una suposición

Sigue la cadena causal, inspecciona las líneas citadas y prepara el escalado para infraestructura. Abre cualquier captura a tamaño completo.

Rastrea fallos en cascada hasta su origen
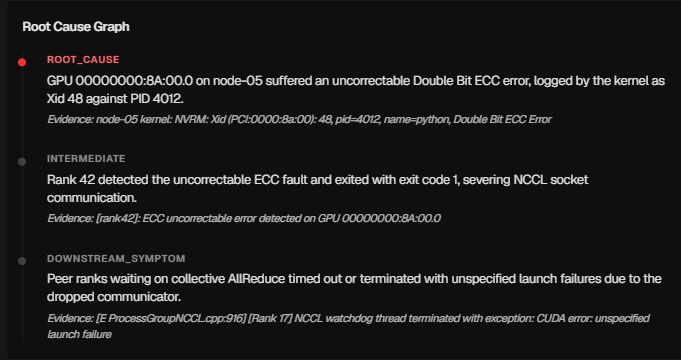
Grafo causal de Denpex que conecta un error ECC Xid 48 con la caída del rank y timeouts NCCL posteriores.
Captura de un caso NCCL/ECC: enlaza evento de hardware, caída del rank y síntomas derivados con líneas citadas.Ver imagen original

Prepara el traspaso de hardware para RMA
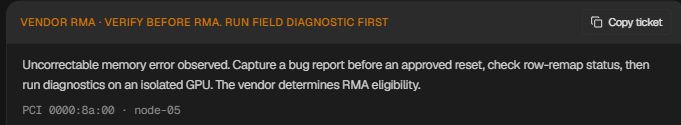
Resumen de hardware Denpex indicando conservar evidencia antes del reinicio y verificar elegibilidad RMA.
Vista de entrega física del mismo ejemplo: reúne UUID y dmesg antes de aprobar un reinicio.Ver imagen original

Muestra con claridad qué evidencia falta
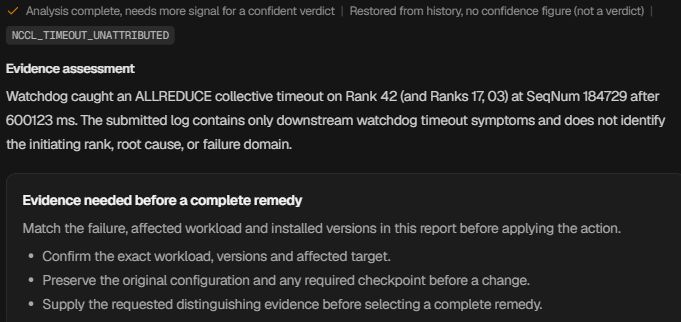
Evaluación de Denpex indicando cuando un timeout AllReduce por sí solo no señala el origen.
Evaluación objetiva del historial: deja claro qué registros faltan antes de reiniciar nodos.Ver imagen original

Completa el diagnóstico dentro de tu editor
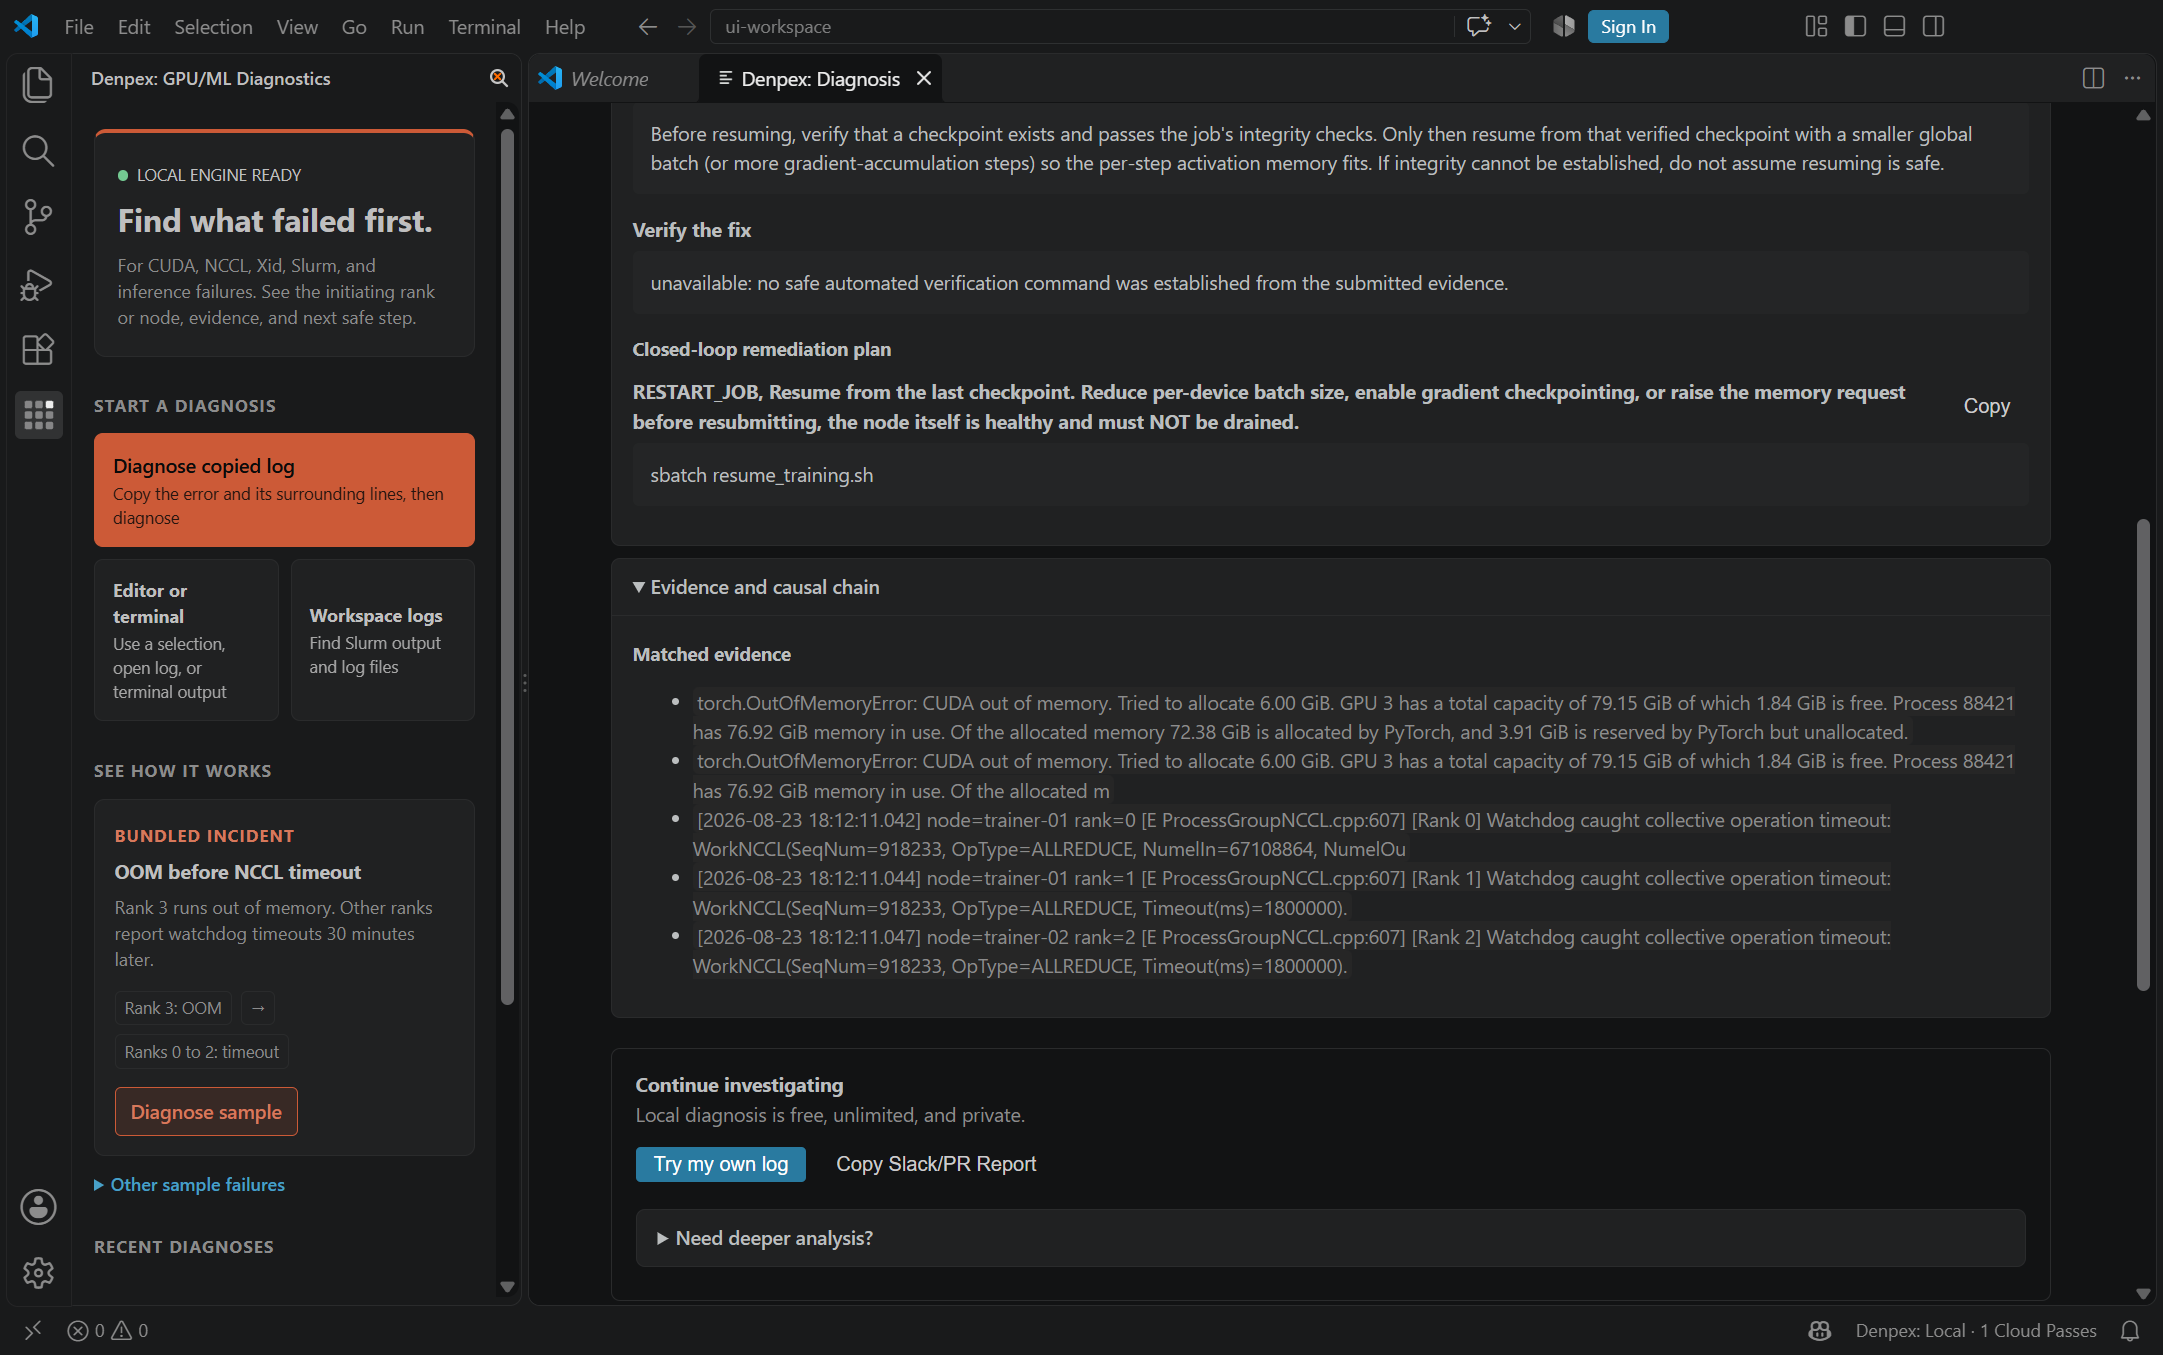
Extensión VS Code de Denpex mostrando el caso OOM-before-NCCL con evidencia citada y guía de verificación.
Captura real de la extensión VS Code: inspecciona evidencia y pasos siguientes sin salir del editor.Ver imagen original
Patrón habitual de fallo

España y LATAM GPU H100 / vLLM - (confirmado mediante evidencia local)

Abrir calculadora VRAM en español

Patrón frecuente de incidente

Cuando vLLM o un entrenamiento multi-GPU se detiene con WorkNCCL AllReduce timeout tras un fallo silencioso en un solo trabajador, localiza el rango de origen sin reiniciar todo el cluster.

Ejemplo de señal (España y LATAM GPU H100 / vLLM)
es-gpu-node-03:2890:2914 [0] misc/ibvwrap.cc:284 NCCL WARN Call to ibv_poll_cq returned error 12 (Transport retry counter exceeded)
ValueError: No available memory for the cache blocks. Try increasing gpu_memory_utilization.

Variables de entorno recomendadas para capturar evidencia

Añade estas banderas en tu contenedor o script de lanzamiento para registrar el nodo exacto donde comenzó el fallo:

NCCL_DEBUG=INFOTORCH_NCCL_ASYNC_ERROR_HANDLING=1TORCH_NCCL_DUMP_ON_TIMEOUT=1CUDA_DEVICE_ORDER=PCI_BUS_ID

Límites de diagnóstico y privacidad

Denpex procesa únicamente fragmentos de logs aportados por el usuario, con enmascarado local en navegador y sin acceso a credenciales privadas.

Otros flujos por proveedor GPU

Compara arquitecturas InfiniBand, RoCEv2, Kubernetes y bare-metal multi-nodo.

RunPoden
Separate container socket misrouting from a true worker stall on RunPod.
Lambdaen
Distinguish an InfiniBand mlx5 fabric flap from an application rank stall on Lambda.
Vast.aien
Isolate motherboard PCIe P2P restrictions and /dev/shm limits on Vast.ai hosts.
Scalewayen
Separate RoCE v2 GID routing mismatches from DeepSpeed ZeRO-3 stage stalls on Scaleway.
CoreWeaveen
Link Kubernetes pod restarts directly to underlying Xid 79 or NVLink hardware faults.
Crusoe Clouden
Pinpoint which straggler rank or RoCE link slowed down your Crusoe Cloud cluster.
Hetzneren
Fix vSwitch MTU fragmentation and NCCL socket discovery on Hetzner bare metal.
TensorDocken
Untangle NAT port forwarding and c10d rendezvous timeouts on TensorDock VMs.
さくらインターネット 高火力ja
さくら高火力サービスにおけるH100 NDR/RoCE NCCLタイムアウトの自動診断
GPUSOROBAN (Highreso)ja
GPUSOROBANにおける多重GPU P2P通信ストールとPCIeトポロジ競合の解決
네이버 클라우드 플랫폼ko
네이버 클라우드 GPU 인스턴스 DDP 랑데부 멈춤 및 VPC MTU 병목 진단
TWCC (台灣智慧雲 / Taiwania)zh-TW
TWCC 台灣智慧雲 GPU 叢集 Xid 79 PCIe 掉卡與 Slurm 任務卡死自動診斷
Nebiusen
Isolate InfiniBand fabric drops and Soperator node faults on Nebius.
KakaoCloudko
KakaoCloud GPU 클러스터의 NCCL 타임아웃과 네트워크 병목 분리 진단
SMC (Sustainable Metal Cloud Singapore)en
Isolate InfiniBand NDR rail faults and multi-node NCCL stalls in Singapore.
Hyperstack (UK & Europe)en-GB
Separate UK VM network bottlenecks from H100 hardware drops on Hyperstack.
CUDO Compute (UK & Europe)en-GB
Untangle virtualized PCIe topology and /dev/shm traps on CUDO Compute.
OVHcloud (France & Europe)en
Isolate OVHcloud vRack VLAN fragmentation from GPU silicon faults.
Verne & Nordic H100 Clustersen
Separate Slurm cgroup evictions from InfiniBand stalls on Nordic clusters.
Core42 (UAE Sovereign AI Cloud)en
Pinpoint initiating silicon and InfiniBand faults in thousand-GPU runs.
Firmus & ResetData (Australia)en
Separate network topology timeouts from hardware Xids on Australian GPUs.
KT Cloud · NHN Cloud (한국 GPU 클러스터)ko
KT Cloud · NHN Cloud 멀티노드 H100 환경의 NCCL 타임아웃 원인 분리
GMO GPUクラウド · ABCI 3.0 (H200)ja
H200 InfiniBand NDR 通信障害と Slurm 強制終了を瞬時に切り分け
Ubilink 友崴超算 (台灣與港澳 H100 叢集)zh-TW
精準隔離 Ubilink H100 多節點訓練中的鏈路異常與硬體掉卡
Hetzner Deutschland & DACH GPU Clusterde
PCIe-P2P-Hänger, NCCL-Timeouts und Xid 79 auf DACH-GPU-Servern sauber isolieren
OVHcloud & Scaleway France H100fr
Séparer les pannes réseau RDMA/RoCE des erreurs Xid 79 et OOM hôte
Brasil e LATAM GPU H100 (NCCL / OOM)pt
Separe CUDA OOM, falhas de link NCCL e quedas Xid 79 antes de reiniciar nós