Skip to content

Für KI-Teams in Deutschland, Österreich und der Schweiz auf Bare-Metal- und H100-Clustern

PCIe-P2P-Hänger, NCCL-Timeouts und Xid 79 auf DACH-GPU-Servern sauber isolieren

Unterscheiden Sie NCCL_IB_DISABLE / P2P-Topologiekonflikte, volle /dev/shm Container-Mounts und physische Xid 79/74/48 Hardware-Signale anhand zitierter Log-Beweise.

30-Tage-Team-Evaluation. Keine Kreditkarte, keine automatische Abbuchung.

Live-Diagnose ohne Login

Hetzner & DACH Cluster-Log lokal prüfen

Fügen Sie ein anonymisiertes Trainer-, dmesg- oder NCCL_DEBUG=INFO-Log aus Ihrer GPU-Umgebung ein, um Root-Cause, Zitate und nächste Prüfschritte zu erhalten.

Vor dem Upload lesen: Cloud-Datenverarbeitung & lokale Offline-Optionen.

training_logs.txt
Kein eigenes Log zur Hand? Beispiel auswählen:

Große Logdateien werden direkt in Ihrem Browser vorgefiltert. Nur ausgewählte Belege werden bei der Diagnose übermittelt.

3 kostenlose Cloud-Diagnosen pro Tag

Denpex 30 Tage testen. KOSTENLOS.

Keine Kreditkarte. Kein automatisches Abo. Prüfen Sie an einem bereits bekannten Vorfall, ob Denpex Ihrem Team hilft.

Kostenlose 30-tägige Team-Testphase starten

Bis zu 50 Diagnosen pro Tag für 30 Tage. Bestätigen Sie Ihre geschäftliche E-Mail-Adresse, spielen Sie einen gelösten Vorfall nach und vergleichen Sie Evidenz sowie nächste Schritte mit Ihrer bestätigten Ursache.

Verwenden Sie Ihre Firmen-E-Mail, zum Beispiel alex@ihrunternehmen.de.

Wer ist berechtigt?

Unternehmensdomains aktivieren nach E-Mail- und Domainprüfung automatisch die 30-tägige Team-Testphase (bis zu 50 Diagnosen täglich). Falls die automatische Prüfung fehlschlägt, hilft support@denpex.com. Lokale Diagnosen in der IDE-Erweiterung benötigen kein Konto.

Nutzen Sie eine private Adresse (Gmail, Outlook, GMX) oder ein Einzel-Cluster? Kostenloses $0-Konto erstellen (ohne Firmen-E-Mail), um 7 Tage Verlauf zu speichern, oder senden Sie ein Cluster-Crash-Log für eine Live-Analyse.

Was eine technische Evaluation in 30 Tagen belegt

Verifizierbarer Befund für interne Plattform-Teams oder Hetzner-Hardware-Support.

Denpex klassifiziert direkt zitierbare Signale aus dem vorliegenden Log und benennt fehlende Beweise transparent statt zu raten.

Einblick in Denpex

Beweise direkt im Log sehen statt pauschaler Vermutungen

Folgen Sie der Kausalkette, prüfen Sie zitierte Rohzeilen und bereiten Sie die Übergabe für Infrastruktur-Teams vor. Öffnen Sie jede Ansicht bei Bedarf in voller Größe.

Kaskadierte Fehler bis zum Ursprung verfolgen
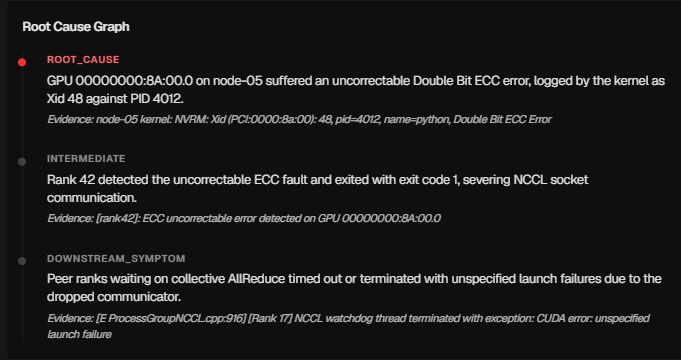
Denpex Kausalgraph verknüpft Xid 48 ECC-Fehler mit Rank-Abbruch und folgenden NCCL-Timeouts samt zitierten Logzeilen.
Ansicht aus einem NCCL/ECC-Vorfall: verknüpft Hardware-Ereignis, Rank-Abbruch und Folgesymptome mit exakten Zitaten.Originalbild öffnen

Beweissicherung für Hardware-RMA vorbereiten
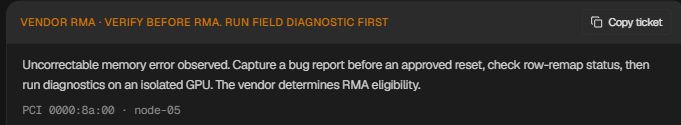
Denpex Hardware-Übergabe zeigt Beweissicherung vor einem Node-Reset und RMA-Vorprüfung.
Hardware-Übergabeblatt zum selben Beispiel: UUID, dmesg und ECC-Zähler vor einem Reset sichern.Originalbild öffnen

Fehlende Diagnosebelege klar kennzeichnen
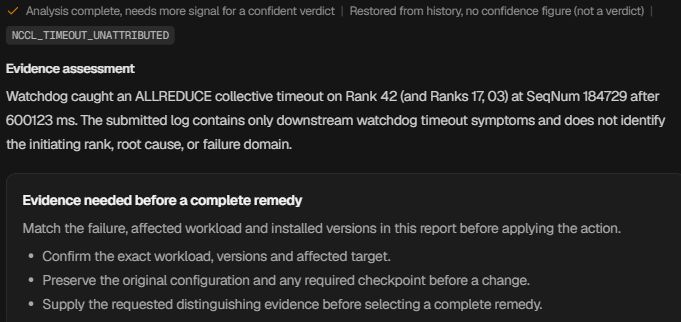
Denpex Bewertung zeigt, wann ein reiner AllReduce-Timeout für eine schlüssige Ursache noch nicht ausreicht.
Aus der Verlaufsansicht: benennt transparent, welche Belege vor einem Neustart noch eingesammelt werden müssen.Originalbild öffnen

Untersuchung direkt im Editor abschließen
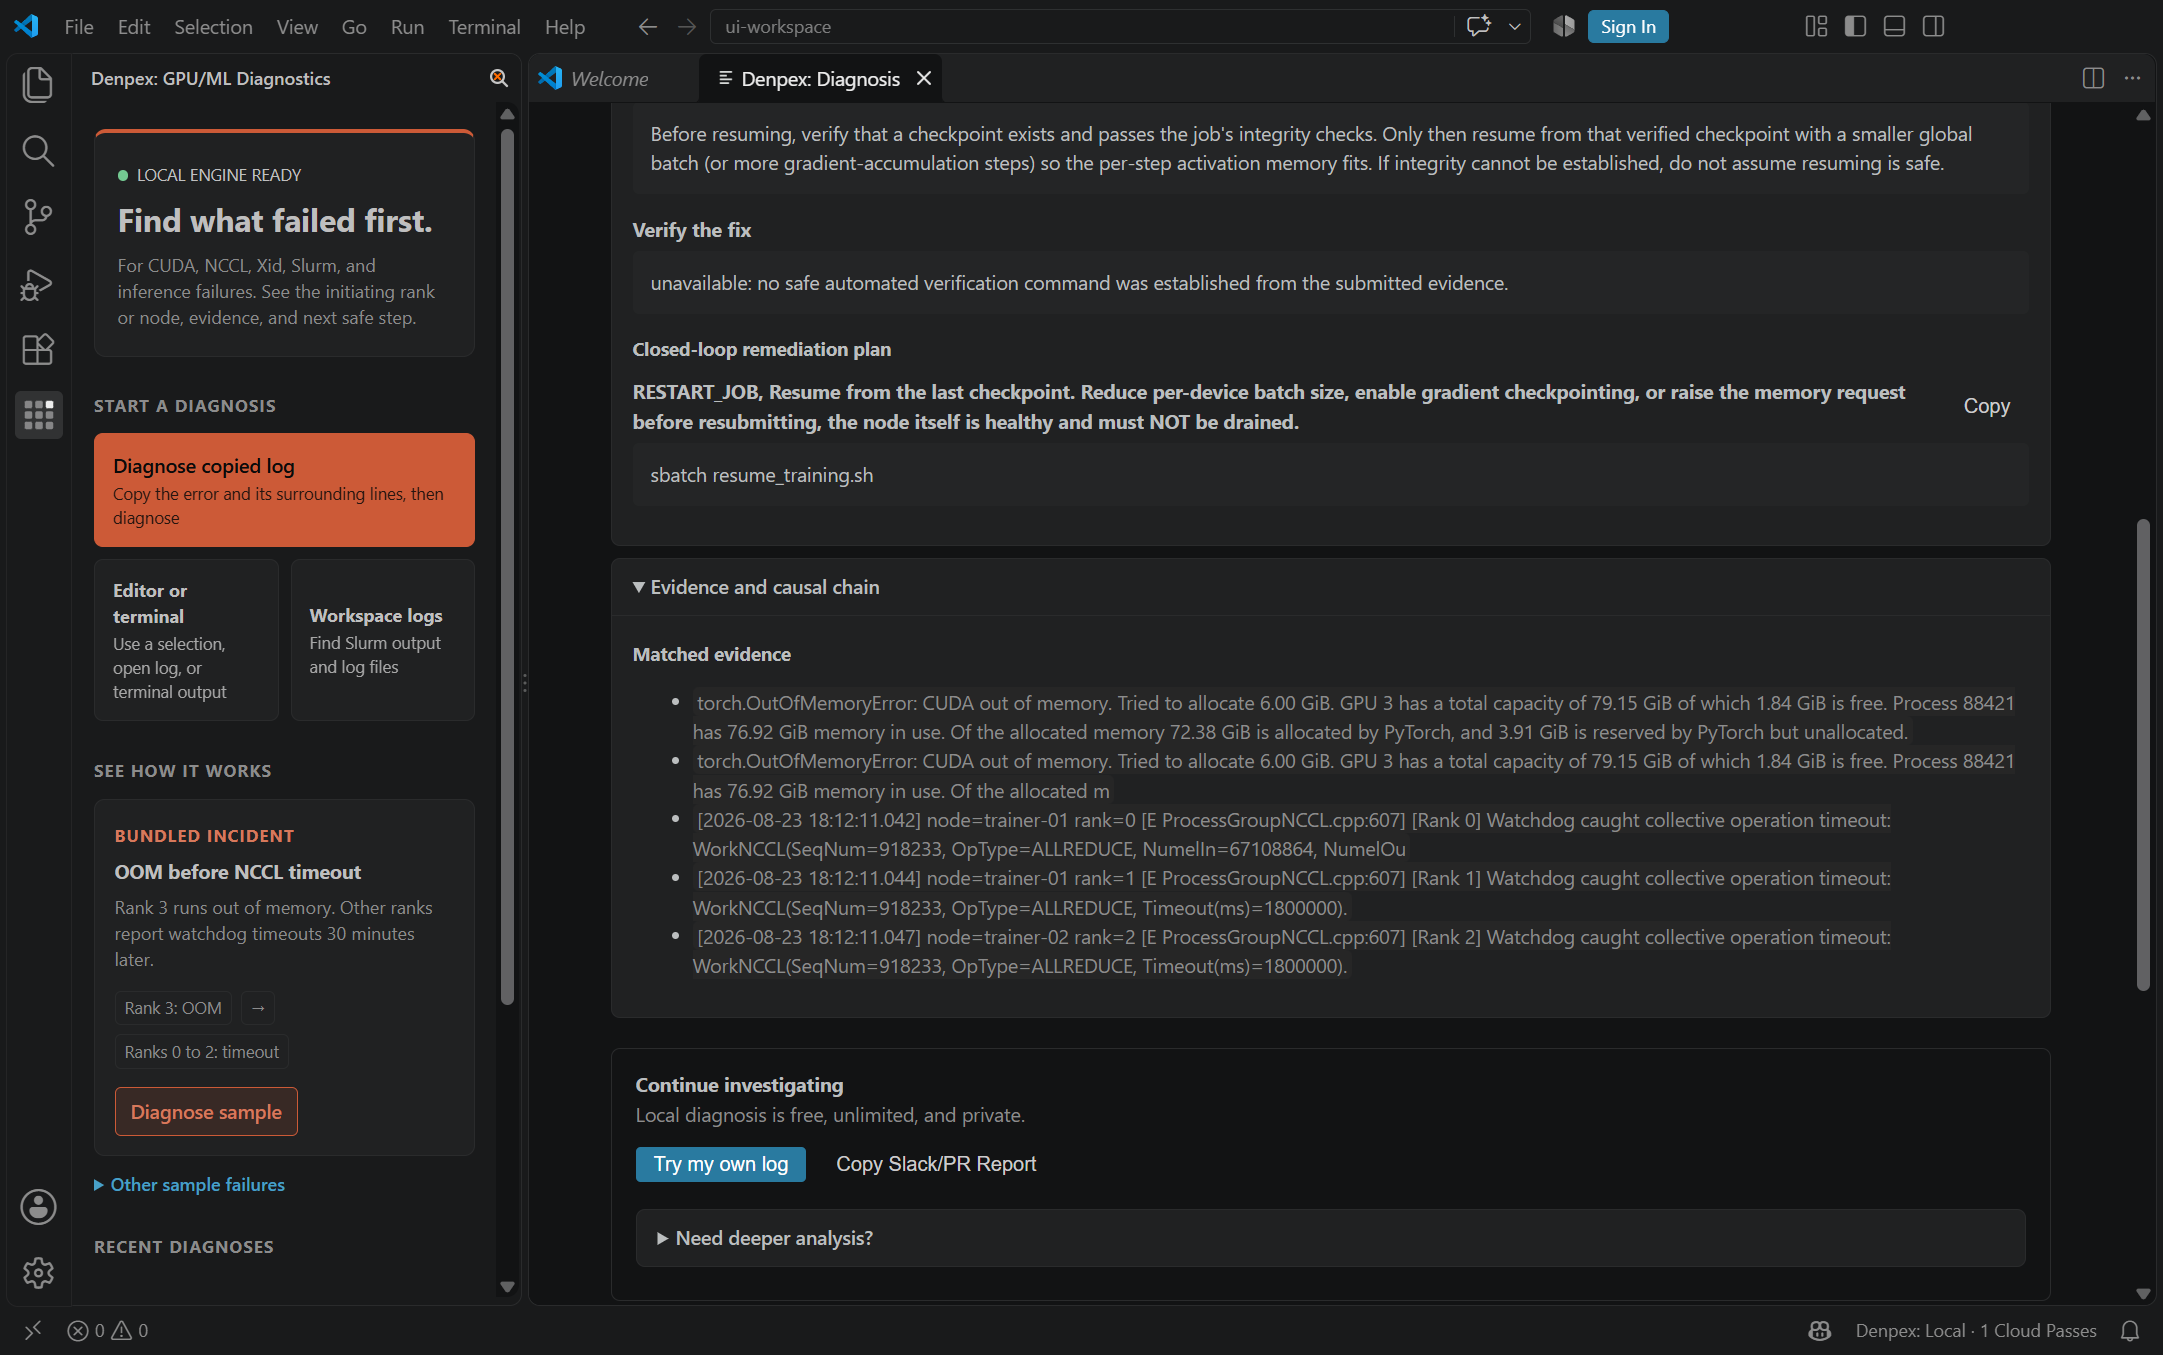
Denpex VS Code Erweiterung zeigt OOM-before-NCCL Beispiel mit Log-Belegen und nächsten Schritten.
VS Code Erweiterung im lokalen Einsatz: Log-Evidenz und Prüfschritte ohne Verlassen des Editors.Originalbild öffnen
Typisches Fehlersymptom im Betrieb

Hetzner Deutschland & DACH GPU Cluster - (lokale Log-Evidenz erforderlich)

Offizielle Hetzner GPU Informationen öffnen

Häufiges Cluster-Fehlerbild

Wenn ein verteilter Trainingslauf über mehrere Bare-Metal-Server wegen Socket- bzw. P2P-Blockaden abbricht oder ein Worker zuerst per Host-OOM stirbt, benennt Denpex exakt den auslösenden Knoten.

Auszug des Fehlersignals (Hetzner Deutschland & DACH GPU Cluster-Muster)
hetzner-gpu-de-02:3114:3190 [1] misc/socket.cc:420 NCCL WARN Bootstrap : Connection timed out
NVRM: Xid (PCI:0000:81:00): 79, pid=9412, name=pt_main_thread, GPU has fallen off the bus.

Empfohlene Diagnose-Flags für saubere Tracebacks

Setzen Sie diese Umgebungsvariablen im Trainings-Container, um im Fehlerfall vollständige Rank- und Transport-Beweise zu erhalten:

NCCL_DEBUG=INFONCCL_SOCKET_IFNAME=eth0TORCH_NCCL_ASYNC_ERROR_HANDLING=1CUDA_DEVICE_ORDER=PCI_BUS_ID

Diagnosegrenzen & Datenschutz

Denpex wertet ausschließlich vom Nutzer bereitgestellte Log-Auszüge lokal oder maskiert aus und greift auf keine fremde Infrastruktur zu.

Weitere GPU-Cloud-Diagnose-Workflows

Vergleichen Sie Multi-Node-Netzwerke, Kubernetes-Pods und Bare-Metal-Setups nach Anbieter.

RunPoden
Separate container socket misrouting from a true worker stall on RunPod.
Lambdaen
Distinguish an InfiniBand mlx5 fabric flap from an application rank stall on Lambda.
Vast.aien
Isolate motherboard PCIe P2P restrictions and /dev/shm limits on Vast.ai hosts.
Scalewayen
Separate RoCE v2 GID routing mismatches from DeepSpeed ZeRO-3 stage stalls on Scaleway.
CoreWeaveen
Link Kubernetes pod restarts directly to underlying Xid 79 or NVLink hardware faults.
Crusoe Clouden
Pinpoint which straggler rank or RoCE link slowed down your Crusoe Cloud cluster.
Hetzneren
Fix vSwitch MTU fragmentation and NCCL socket discovery on Hetzner bare metal.
TensorDocken
Untangle NAT port forwarding and c10d rendezvous timeouts on TensorDock VMs.
さくらインターネット 高火力ja
さくら高火力サービスにおけるH100 NDR/RoCE NCCLタイムアウトの自動診断
GPUSOROBAN (Highreso)ja
GPUSOROBANにおける多重GPU P2P通信ストールとPCIeトポロジ競合の解決
네이버 클라우드 플랫폼ko
네이버 클라우드 GPU 인스턴스 DDP 랑데부 멈춤 및 VPC MTU 병목 진단
TWCC (台灣智慧雲 / Taiwania)zh-TW
TWCC 台灣智慧雲 GPU 叢集 Xid 79 PCIe 掉卡與 Slurm 任務卡死自動診斷
Nebiusen
Isolate InfiniBand fabric drops and Soperator node faults on Nebius.
KakaoCloudko
KakaoCloud GPU 클러스터의 NCCL 타임아웃과 네트워크 병목 분리 진단
SMC (Sustainable Metal Cloud Singapore)en
Isolate InfiniBand NDR rail faults and multi-node NCCL stalls in Singapore.
Hyperstack (UK & Europe)en-GB
Separate UK VM network bottlenecks from H100 hardware drops on Hyperstack.
CUDO Compute (UK & Europe)en-GB
Untangle virtualized PCIe topology and /dev/shm traps on CUDO Compute.
OVHcloud (France & Europe)en
Isolate OVHcloud vRack VLAN fragmentation from GPU silicon faults.
Verne & Nordic H100 Clustersen
Separate Slurm cgroup evictions from InfiniBand stalls on Nordic clusters.
Core42 (UAE Sovereign AI Cloud)en
Pinpoint initiating silicon and InfiniBand faults in thousand-GPU runs.
Firmus & ResetData (Australia)en
Separate network topology timeouts from hardware Xids on Australian GPUs.
KT Cloud · NHN Cloud (한국 GPU 클러스터)ko
KT Cloud · NHN Cloud 멀티노드 H100 환경의 NCCL 타임아웃 원인 분리
GMO GPUクラウド · ABCI 3.0 (H200)ja
H200 InfiniBand NDR 通信障害と Slurm 強制終了を瞬時に切り分け
Ubilink 友崴超算 (台灣與港澳 H100 叢集)zh-TW
精準隔離 Ubilink H100 多節點訓練中的鏈路異常與硬體掉卡
OVHcloud & Scaleway France H100fr
Séparer les pannes réseau RDMA/RoCE des erreurs Xid 79 et OOM hôte
España y LATAM GPU H100 / vLLMes
Separa errores de red NCCL, caídas PCIe Xid 79 y límites de memoria vLLM
Brasil e LATAM GPU H100 (NCCL / OOM)pt
Separe CUDA OOM, falhas de link NCCL e quedas Xid 79 antes de reiniciar nós